机器人明明抓空了,世界模型却预测它成功抓起了水果。
这不是科幻桥段,而是行业的普遍现象:给定完全相同的初始画面和动作序列,主流世界模型可以生成一段画面逼真、却与真实执行完全相反的视频。
如果不是把预测画面和真实执行放在一起逐帧对照,这次失败就被完美地掩盖了——而这类偏差,正在主流世界模型中系统性存在。
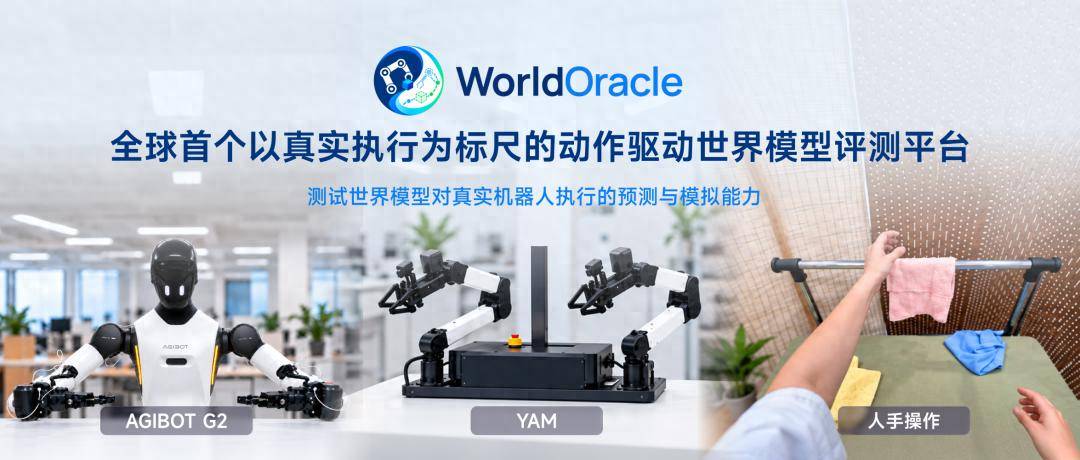
10 月 16 日,全球首个以真实执行为标尺的动作驱动世界模型评测平台 WorldOracle 正式发布,并向开发者开放评测提交。 项目由智元、NVIDIA、普林斯顿大学、得克萨斯大学奥斯汀分校、多伦多大学的研究人员联合完成,团队既有世界模型研发者,也有评测基准研究者。
WorldOracle 直击行业一直没有基准正面回答的问题:给定一组动作,模型预测的未来,和真实发生的过程,究竟差多少?
01 三个"压力测试",对世界模型"测谎"
过去一年,世界模型生成的视频越来越逼真,但"像不像"和"真不真"是两回事。当世界模型被用作机器人的"预演沙盘"——筛选动作方案、评估策略、生成训练数据——一次失败操作在模型里被预测成成功,机器人就会系统性高估自己。
此前的评测要么在仿真环境里跑,要么只考文本驱动的视频生成。WorldOracle把考场搬到了真机实录现场:预先采集真实操作的画面与动作序列,让模型在相同条件下开放回放生成预测,再与真实执行逐帧对照。真实操作里的抓空、掉落、洒水被完整保留——准确预测失败,同样得高分。
WorldOracle 给这种"预测与真实执行的吻合程度"起了一个名字:执行一致性(Execution Coherence)。一个可靠的世界模型,必须扛住三重压力测试——
因果服从:模型必须严格跟随给定动作序列,包括错误的动作、失败的操作。现实抓空了,预测出抓空才是满分答案;把失败"脑补"成成功,就是幻觉。
分布迁移:动作可以来自人类遥操作,也可以来自机器人策略的自主执行——后者带着停顿、抖动和临场修正,模型不能只会应付"标准操作"。
时序耐力:不是预测前 10 秒像不像,而是连续操作 120 秒后,误差是否还在可控范围内。
这三重压力测试,WorldOracle 全部用真实世界的执行记录做标尺:预先采集真实操作的画面与动作,让模型在相同初始画面和动作序列下开放回放(open-loop replay)生成预测,再逐帧对照真实执行评分。
对已有基准的对比研究发现,WorldOracle 是目前唯一同时做到"动作条件化 + 真实数据 + 含失败样本 + 长时序 + 多本体 + 多视角 + 策略自主执行分布"七项的评测基准——此前最接近的工作要么依赖仿真环境,要么只考文本驱动的视频生成。
02 335条真机轨迹、四成失败样本,考卷本身先过了"可信度测试"
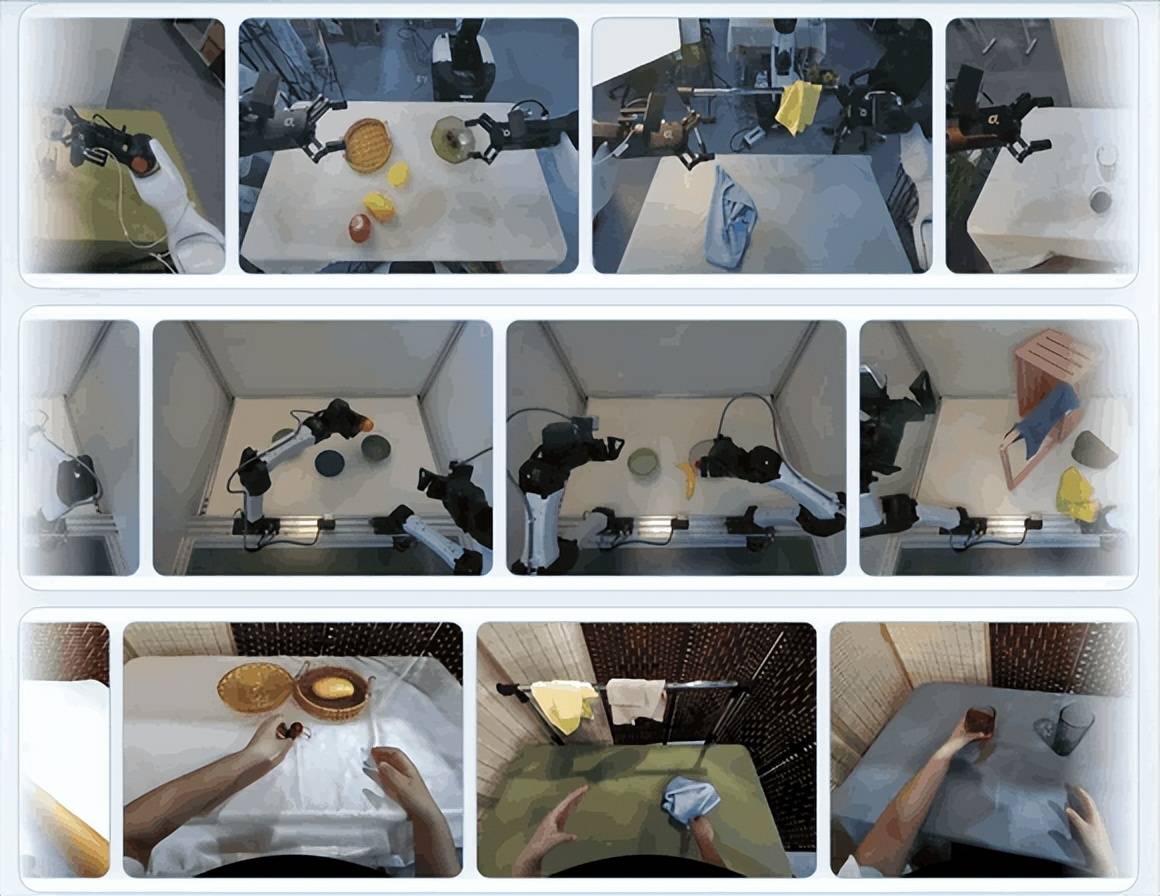
WorldOracle 的考题全部来自真机实拍,且是全球首个把"失败"当核心考点的世界模型基准:
335 条评测轨迹:智元精灵G2机器人 100 条、YAM 机器人 75 条、人类第一视角手部操作 100 条、G2策略自主执行 60 条,每条约 2 分钟;
约 40% 的交互片段是失败或次优执行:抓空、掉落、洒水都被完整保留——这是全球首个把"失败"当作核心考点的世界模型基准;
03类任务覆盖 4 种物理形态:水果抓取(刚体)、挂毛巾(柔性体)、倒水(流体)、开合抽屉(关节体);
训练配套:团队新采集了 1,779 条 G2 训练轨迹(含约 20% 失败片段),并为 YAM 配套公开的 ABC-130K 数据集;人类手部场景则完全零样本(zero-shot)考验模型的泛化能力。
评测流程对参赛者非常友好:无需自采真机数据,用评测集提供的初始画面和动作序列生成预测视频提交即可,平台自动对照真实执行评分。
值得一提的是标注管线的"工业化"程度:VLM 为每个交互片段的结果关键帧自动生成物理判据(如"绿色杯子已被夹爪抓住"),SAM3 逐帧分割物体、机械臂和人手区域,评测聚焦在真正发生交互的地方——而不是让大面积背景稀释误差。
阅卷标准也经受了检验:119 名参与者对 128 对预测进行盲评(预测匿名、随机排序、与真实执行对照),四项指标与人类判断的一致率为 88.1%–93.2%,Spearman 相关性 0.72–0.82。
即使在分差极小、肉眼难辨的样本组里,一致率也显著高于随机水平——分数差距小,人类偏好依然跟着指标走。
控制实验进一步证明:关键区域指标随交互区域内的失真加重而单调下降,但背景单独变化时几乎不动——指标抓的确实是"交互处的错误",不是背景噪声。
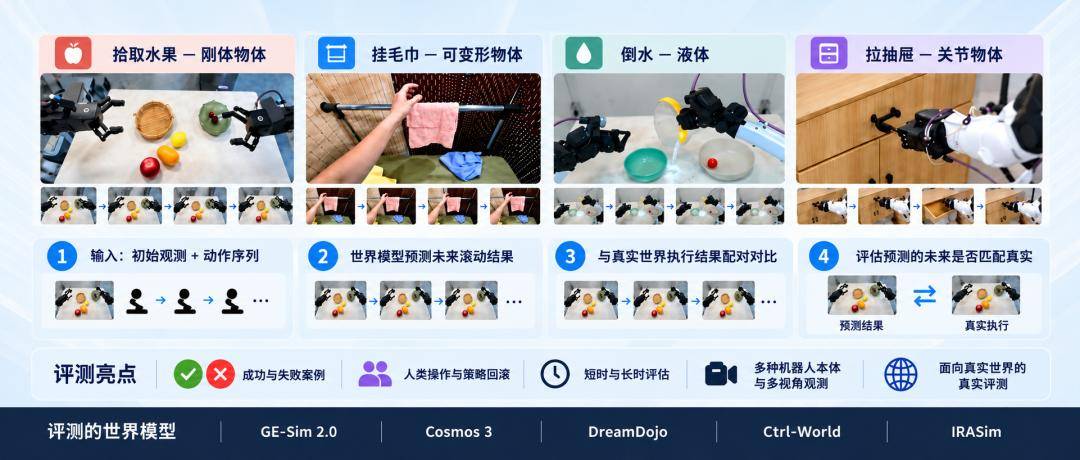
WorldOracle 真实操作数据展示:覆盖刚体、柔性物体、流体与关节物体交互,基于相同初始观察和动作序列,对照真实执行检验预测结果
03 七个模型同台大考:五个发现,个个扎心
研究横评了 7 个代表性动作驱动世界模型:IRASim、Ctrl-World、DreamDojo、Cosmos 3、GE-Sim 2.0、JointControlVideo、OSCAR。成绩单读起来像一部"大型翻车现场纪录片",但每一条翻车记录都指向明确的技术坐标。
发现一:机械臂会"演戏",物体才是说谎者。
把空间对齐指标拆成"机械臂"和"被操作物体"两部分后,所有模型无一例外出现巨大落差:G2 人工操作轨迹上,IRASim 机械臂得分 78.8,物体仅 29.1,相差近 50 分;Cosmos 3 是 89.4 对 45.4;即便最强的 GE-Sim 2.0,机械臂 100.0、物体也只有 62.8。
也就是说:机械臂的运动被精确复刻了,但它对世界造成的影响——水果有没有被抓走、毛巾有没有滑落、水有没有进杯——模型其实"没看住"。 机械臂伸到哪里只是操作的一半,"这一动带来了什么"才是机器人真正需要预演的东西。
发现二:120 秒,是多数世界模型的"记忆极限"。
把预测窗口从 10 秒逐步拉长到 120 秒,衰减曲线触目惊心:G2 人工操作数据上,GE-Sim 2.0 的单视角综合分从 10 秒时的 86.1 跌至 120 秒的 63.4,而其余模型在长时程末端只剩 26.7–35.1 分。
按完整轨迹计,DreamDojo 从 50.56 掉到 27.08,Cosmos 3 从 53.99 掉到 26.60——短时预测的分数,几乎不能用来预判长时表现。
在世界模型开始承担机器人闭环训练的当下,"熬不过两分钟"意味着它目前还撑不起长程规划。
发现三:动作跟得越准,越会掩盖结果的错误。
最发人深省的发现是:空间对齐和物理结果正确,是两种独立的能力。
GE-Sim 2.0 在完整轨迹上多视角一致性高达 96.96、空间对齐 73.49,但物理状态正确性只有 60.26——机械臂在所有相机视角里都"演得很像",水果的结局却可能完全是错的。
论文中的极端案例:一段预测的空间对齐 80.8 分,物理状态却是 0.0 分(抽屉实际全关,模型预测成了拉开)。
这解释了为什么单一指标、单一只看"像不像"的评测会失灵:一个模型可以在所有视角里精确地撒同一个谎。
发现四:换了"司机",成绩大幅跳水。
WorldOracle 首次把"机器人策略自主执行"作为独立考区:由 π0.5 策略在真机上闭环运行产生动作,带有人工操作中没有的犹豫、抖动和中途修正。这一换考区,部分模型成绩大幅下滑——Ctrl-World 的物理状态正确性从人工操作下的 51.15 跌至自主执行分布的 27.22。只会应付"标准操作"的世界模型,离真实机器人工作现场还有距离。
发现五:人手,是当前世界模型的"绝对盲区"。
零样本参与人类手部场景的三个模型集体垫底:即便表现最好的模型,物体区域保真度也只有 15.2 分。高自由度的关节运动、可变形的手部外观、精细的接触力学——精准预测"手与物体的交互",仍是全世界模型都没有攻克的难题。 而这恰恰是通用机器人(末端执行器是灵巧手)路线最需要的能力。
04 开放提交:给模型迭代的"试金石"
WorldOracle 已公开榜单和提交指南,支持开放权重与闭源模型。注册审核后,开发者可按模型支持的本体与赛道提交预测视频,查看综合分、分项成绩与逐段对比视频。
对开发者,这套评测把"我的模型变强了吗"拆成了可以验证的具体问题:
一次改进,是让物体的运动更真实了,还是只是让机械臂更"上镜"了?
对失败操作的误判,减少了吗?
预测拉长到两分钟后,提升还在吗?
随着世界模型加速进入机器人规划、策略评估和训练管线,这些问题不能再靠"看起来很像"来回答。
世界模型预测得怎么样,把它生成的未来,和真实发生的过程放在一起看。
欢迎研究者与开发者参与评测。