内容摘要
围绕一条ERP→CRM的产品主数据同步策略,文章讲清了单向数据流、关键字段映射、轻易云的源/目标注册与字典化映射配置,以及「全量初始化→增量轮询→每日全量兜底」的分阶段调度。最后给出5条现场踩坑经验,强调编码字典集中管理、停用状态同步、分类层级压缩等关键点。
核心要点
- 产品主数据同步的核心是编码映射的集中管理,避免散落在脚本里
- 建议采用「增量5分钟轮询 + 每日全量兜底」的双轨调度模式
- 表头主数据先行,附件字段后置,降低单次失败的影响面
- 单位对齐必须落到语义字典,不能只做字符串替换
- 分类树层级不一致时,需要在中间层做可追溯的压缩与映射
这个策略解决什么问题
当企业的产品主数据分散在ERP和CRM两套系统里,编码规则、计量单位、分类体系互相对不上时,销售前端看到的物料和后端供应链看到的物料就是两本账。本文围绕一条具体的同步策略——将ERP侧的产品资料按既定编码映射推送到CRM侧——讲清楚如何用轻易云数据集成平台把这件事做成一个可持续运转的例行任务。

数据流向与字段映射
整体流向是单向推送:源端ERP(产品主数据)→ 轻易云集成平台(中间层,做编码转换、字段映射、去重与校验)→ 目标端CRM(产品资料)。
关键字段对照示例(实际字段以双方系统为准):

在轻易云上如何配置
一次实际项目中,我们用轻易云做这件事时,配置通常落在三处:
- 数据源注册:把ERP侧的产品资料接口注册为源端数据源,CRM侧的物料写入接口注册为目标端数据源。轻易云的连接器负责鉴权与分页拉取,不需要我们手写SDK。
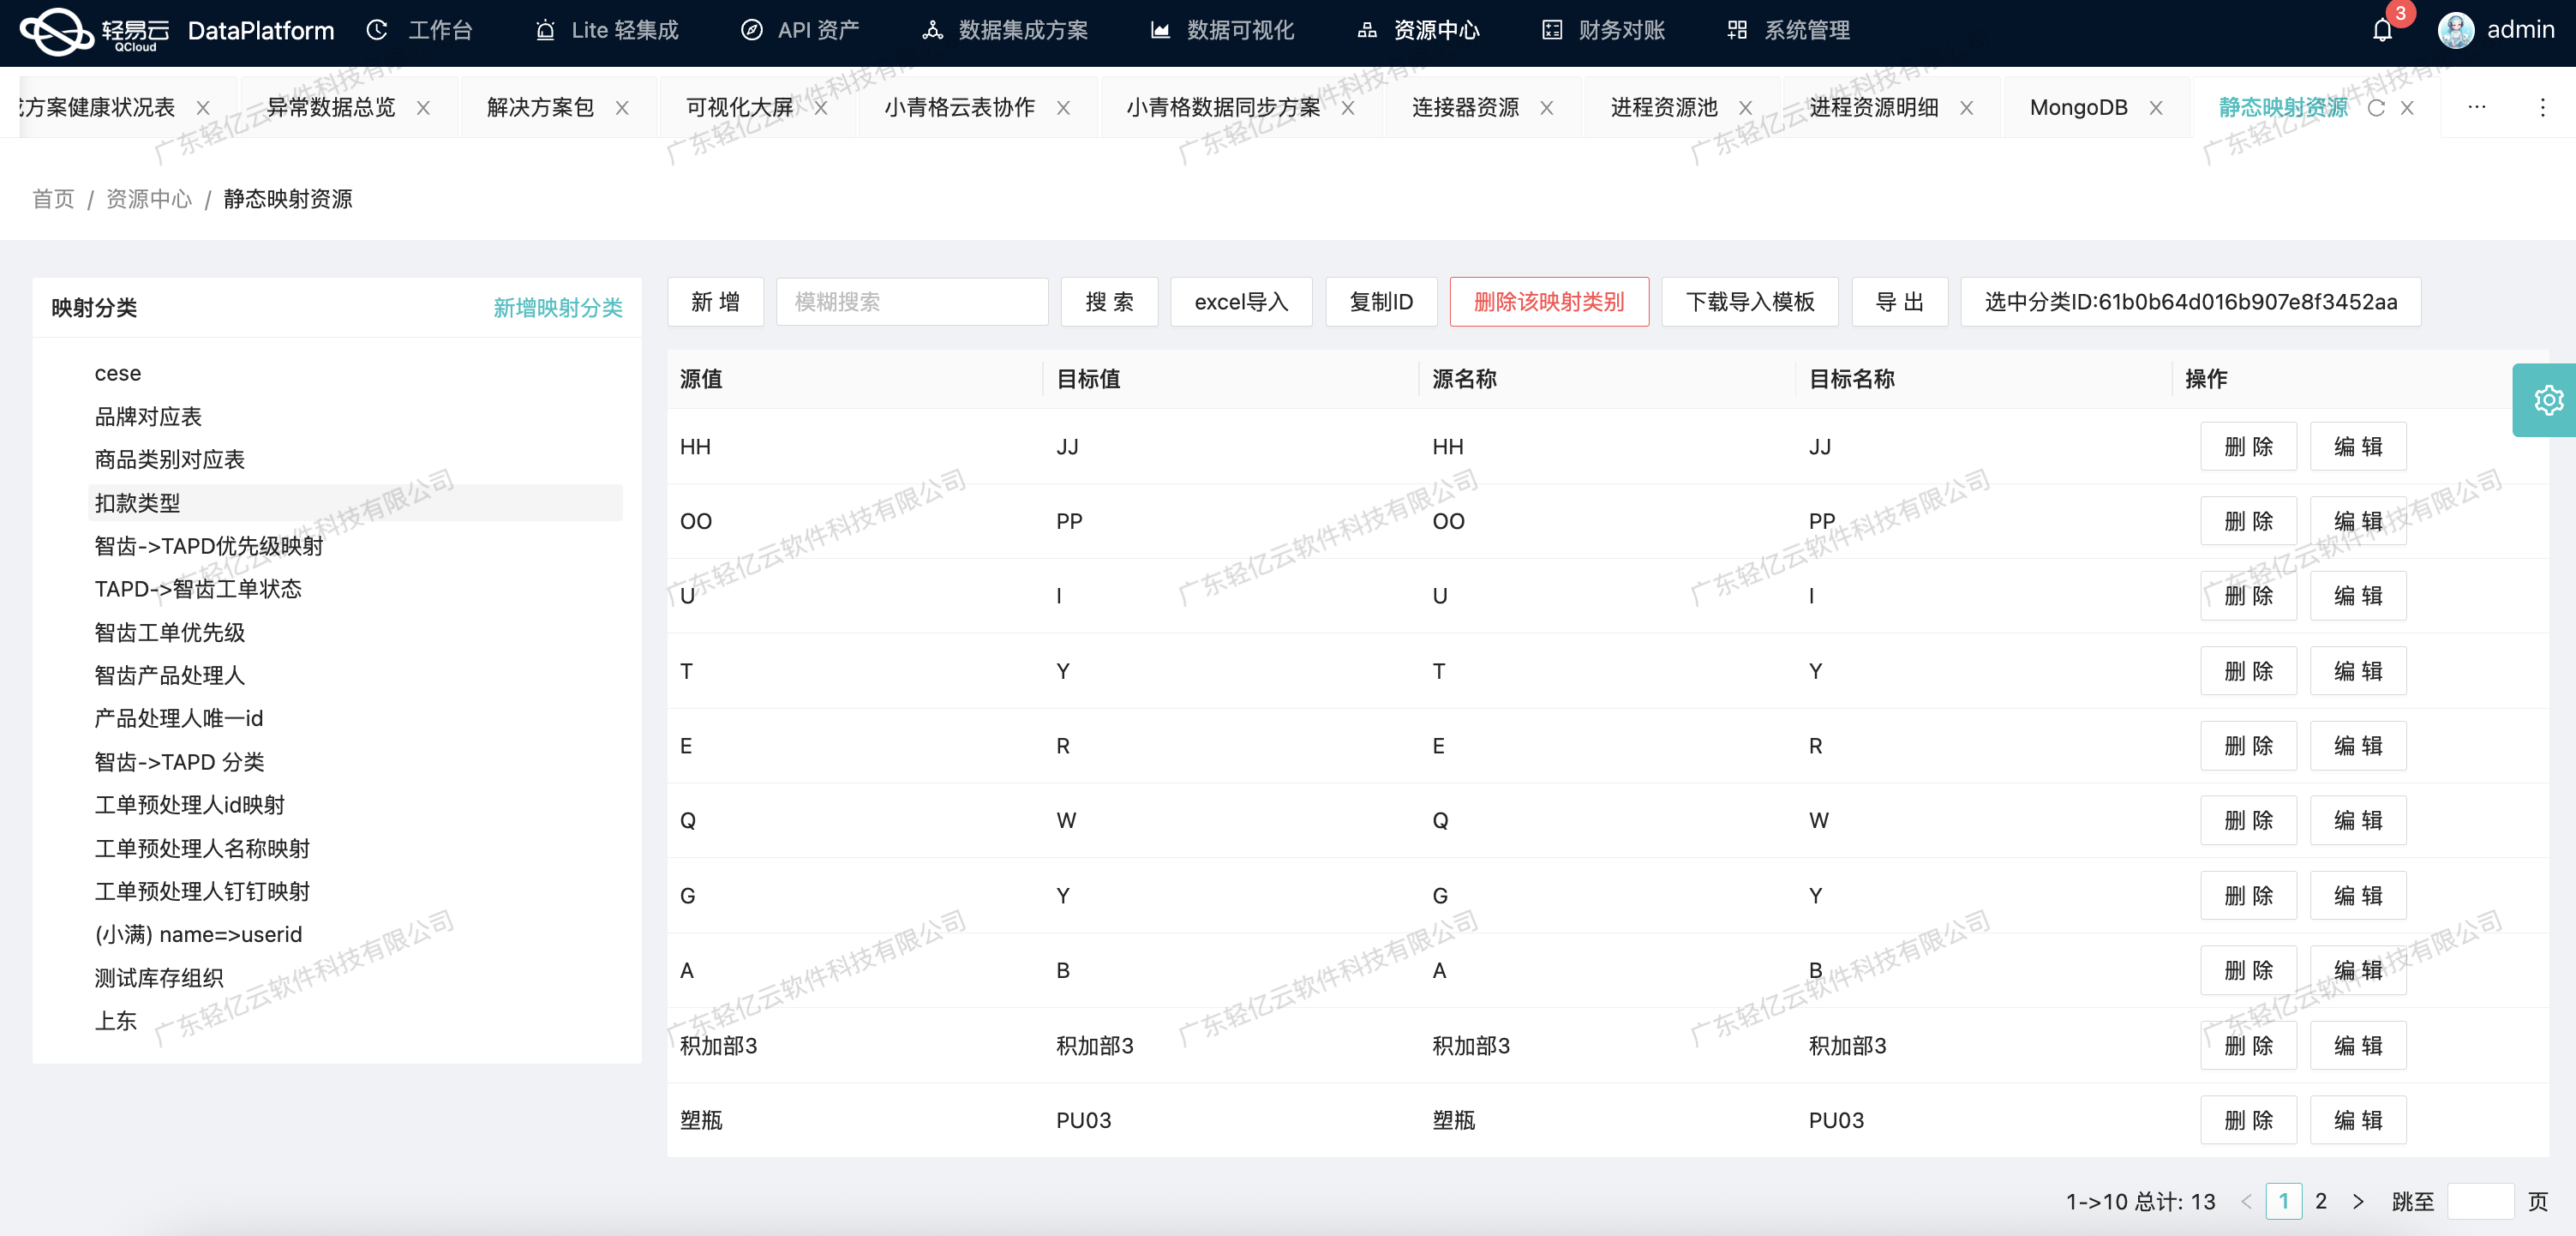
- 映射规则编排:在轻易云的「字段映射」画布里维护上述映射表。这里强烈建议把编码映射、单位字典、分类映射这三类高频变更的规则单独抽出来,集中存放在映射字典里——后续任何一处业务侧调整,只改字典,不改策略本体。
- 目标写入策略:根据CRM侧物料接口的写入语义,决定是按「编码」做覆盖式更新,还是仅新增不覆盖。轻易云客户常见的应对模式是表头表体分阶段:先把产品主表(编码、名称、单位、分类)跑稳,再叠加价格、库存这类附件字段,避免一上来就因附件字段失败拖累主数据。
实施步骤
分阶段调度是把这类主数据同步做稳的关键。
- 第一步:全量初始化。在策略上线前,用一次性任务把ERP侧全部在用产品推一遍到CRM,建立初始基线。这一步要走全量接口,不要带增量条件,确保CRM侧「先有账」。
- 第二步:定义增量起点。全量完成后,记录下「最后成功时间戳」或「最大更新时间」,作为增量起点。这个起点在轻易云里通常以策略参数或调度上下文的形式固化下来。
- 第三步:配置调度频率。产品主数据本身变化不频繁,但销售开新品的频率可能很高。建议采用「增量5分钟轮询 + 每日凌晨全量兜底」的双轨模式:增量保证时效,全量作为安全网,修复任何增量漏单。
- 第四步:异常与对账。在轻易云里挂一个简单的对账节点,对比两侧的产品编码集合,差集落到告警通道,让运维每天能看到差异,而不是上线三个月后才发现两边对不上。
踩坑复盘
- 编码映射分散在脚本里,后期改不动。典型错误是把「ERP编码 → CRM编码」写在每一段转换脚本里。稳妥的做法是在轻易云里维护一张集中的映射字典,业务侧改一次,平台侧一处生效。
- 全量和增量混在一个策略里,重复数据满天飞。把全量初始化和日常增量分成两条独立策略,靠调度先后顺序衔接,不要试图用一个if分支解决。
- 计量单位只对齐文字,没对齐语义。ERP里的「套」和CRM里的「套」可能指的是不同集合口径,必须在中间层落一个明确的单位语义字典,而不是简单字符串替换。
- 停用产品没同步状态,导致CRM侧销售还在下停用品的单。状态字段必须随主数据一起推,并明确启用/停用的取值约定。
- 忽略分类树的层级差。ERP是五级分类,CRM只有三级,直接整段塞进去会被截断或报错。稳妥的做法是在中间层做分类树压缩,并维护一份可追溯的映射表。