像现在很多品牌公司随着互联网的发达,很多用户都会在使用社交媒体发布于对自己品牌的看法,这些有好的评价也有负面的评价!这就会成立舆情监控小组、公关小组!那么还有一些做监控软件的也是为了让监控的更及时,也会想办法去进行优化,那么就迫切需要一套7×24运行的采集程序。很多小白还以为它就是"定时搜一下关键词",真搭过的人都知道,难点全在"持续"两个字上——而能不能持续,八成取决于IP这层做没做对。
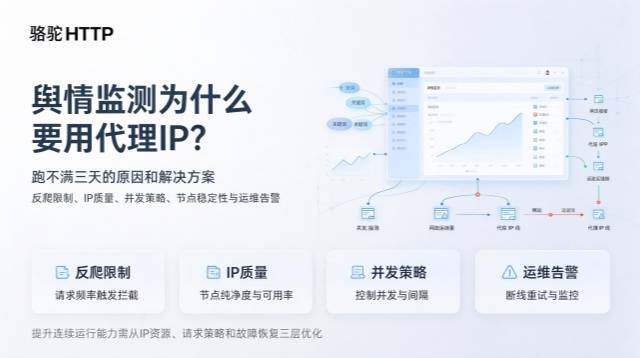
不用代理,系统跑不满三天
三个硬限制,一个个说。
频率墙。 一套像样的舆情系统,每天对目标平台发起几万到几十万次请求。任何一个平台的风控都不会容忍单一IP这个访问量,触发限流只是时间问题。更麻烦的是限流不报错——平台照样返回200,只是内容是验证码或空壳页面,你的程序还以为采集成功了。
地域墙。 热榜、本地资讯、区域媒体的内容,不同城市看到的不一样。舆情的工作恰恰是"知道大家在说什么",只从一个固定出口看,看到的舆论天然是片面的。做区域客户的服务商对此应该深有体会:不挂对应城市的IP,本地论坛和同城热榜根本进不去。
暴露墙。 用公司固定出口IP天天去盯竞对的页面、抓行业敏感话题,对方的后台数据看得一清楚楚。监测这件事本身,最好不要留痕。
三个墙叠起来的后果是一条链:采集中断,数据出现缺口,负面信息恰好落在缺口里,预警晚了几个小时,公关窗口就这么错过。舆情系统的价值按小时计价,这几个小时的代价远超IP成本。
三个常见的坑
坑一:免费或超低价代理池。 IP脏、存活率低是明面上的问题;真正阴的是,脏IP请求回来的是验证码页面,解析程序把"无内容"存进了库,你以为风平浪静,其实是采了个寂寞。这种情况比采不到更危险。
坑二:轮换太机械。 固定每秒换一个IP,请求在时间轴上均匀分布,没有任何真实用户的访问长这样。反爬系统就是靠找这种规律吃饭的。
坑三:失败不重试。 一次失败直接跳过下一条,库里的数据全是洞,趋势图一画全是断点。失败处理不是可选项,是采集系统的地基。
IP策略怎么设计
把IP当成一层独立的调度来设计,而不是采集代码里的一行配置:
- 按平台拆任务。资讯站、社媒、论坛的风控强度和翻页逻辑都不一样,一个任务模板套所有平台是失败的开端。
- 按城市分组。区域监测任务挂对应城市出口,骆驼HTTP动态住宅IP支持按城市筛选,部分线路支持运营商筛选。
- 会话用粘性。需要连续翻页、需要登录态保持的任务,同一个IP保持5-30分钟再换,而不是每个请求都换——翻到第三页换了个IP,平台立刻就警觉了。
- 失败分层处理。单次失败换IP重试;连续失败自动降频并告警,因为连续失败通常意味着目标站改版或风控升级,硬冲只会烧IP。
- 协议对齐现有栈。HTTP/HTTPS/SOCKS5全兼容,配套API文档,主流采集框架(Scrapy、各类RPA)都能直接对接,改造量控制在一两天内。
成本账
中等规模一天5000次请求,用5-15分钟档0.02元/IP,一天100元;大规模一天2万次,用1-5分钟档0.01元/IP,一天200元。按量扣费,监测任务有明显的日内波峰波谷,波谷不产生费用——这是包月方案给不了的弹性。
一条底线
舆情监测只采公开信息,控制请求频率,不碰个人敏感数据。这不光是合规要求——频率克制本身就是采集长期稳定的前提,跑得快的系统先死,跑得稳的系统才有数据积累。
常见问题
动态IP一直换,会话会不会断? 连续操作(翻页、登录态)的任务用粘性会话,同一IP保持5-30分钟;独立请求每次换新IP,两种模式按任务类型分配。
可以按城市监测吗? 可以,支持按城市筛选IP,部分线路支持运营商筛选,满足区域舆情、同城热点类监测需求。
现有系统改造量大吗? 协议层全兼容,配API即可接入;对接遇到问题,技术人员可远程协助调试。