量子硬件最残酷的物理真相,是它时刻都在漂移(Drift)。
零点几毫开尔文的温漂、微观材料缺陷(两能级系统 TLS)的随机跃迁,足以在几分钟内让一台刚调优的芯片参数失真。
这种漂移是量子纠错(QEC)的隐形杀手。解码器要想在海量伴随噪声的奇偶校验中挑出真凶,依赖一套精确标定底层噪声的数值权重(Weights)。权重一旦失真,解码器就会开始误诊,导致逻辑错误率雪崩。
传统的应对极其绝望:停机、重新校准。
为了通过最小化逻辑错误率(LER)训练出一组新权重,后端必须用解码器暴力解算数百万个错误综合征(Syndrome)。
在单核 CPU 上,表面码的一个训练轮次(Epoch)动辄耗时数分钟,当你完成校准,底层的物理硬件早已漂移到了下一个未知的噪声状态。
2026 年 10 月14日,英国纠错芯片龙头 Riverlane 联手英伟达公布了一项打破死结的实测:
将 Riverlane 的局部聚类解码器(Local Clustering Decoder,LCD)部署在英伟达 H100 GPU 上,利用张量并行架构,将原本在 CPU 上需耗时 3 分钟的表面码校准循环,硬生生压缩至 2.8 秒。
这串数字标志着:经典算力巨头正式接管了量子系统的“生命维持中枢”。
解码器校准的底层,是一个极度消耗吞吐量的机器学习优化问题。
为让解码器适应实际硬件的非均匀噪声,系统必须对先验权重进行动态微调,这意味着每一次梯度迭代都要瞬间消化天文数字级的综合征排列组合。单核 CPU 在此直接撞墙。
换上 H100 后,两组工业级实测数据拉开了代际维度的鸿沟:
吞吐量差距逼近 70 倍:单张 H100 跑出每秒处理超 400 万个表面码综合征的峰值吞吐,而单核 CPU 仅能处理约 5.9 万个;
训练周期骤降 65 倍:在旋转表面码的先验优化中,单个训练轮次耗时从约 180 秒断崖式跌至 2.8 秒;在重复码测试中提速达 43 倍。
把校准耗时从“分钟级”砸进“秒级”,彻底重写了系统运行逻辑。
过去由于开销过大,实验室只能采取每天或每周定期校准的消极策略,听任系统在间隙期带着巨大偏差“裸奔”;而在 2.8 秒的窗口内,工程师得以在具体量子线路发射的间隙,见缝插针地完成原位即时校准,将漂移扼杀在毫秒级的临界点前。
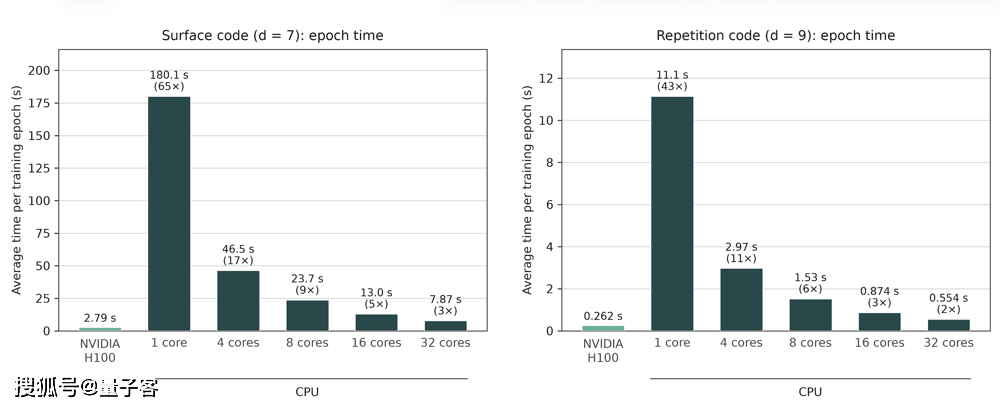
图|LCD 解码器,SI1000 噪声 p = 3×10⁻³,轮数 = d,100 个周期。吞吐量 = 解码的综合征数 / 仅解码时间(GPU:内核时间)(来源:Riverlane)
英伟达的量子防御工事这项实验揭穿了所谓“量子彻底取代经典算力”的轻狂神话。
在真实的容错体系中,算力流事实上被切分成了截然不同的两极:
纳秒级在线实时流:在极低温毫开尔文温区内,由 Riverlane 专用的定制微架构或 FPGA 去硬扛微秒相干窗口内的超低延迟解码;
海量高并发近线/离线流:在室温机柜内,处理环境校准、预解码参数重构及事后噪声消除。
这正是黄仁勋的核心意图。英伟达不必亲自下场造一台前途未卜的超导或中性原子整机,而是凭借 CUDA-Q 与 GPU 集群的高并发壁垒,死死卡住量子控制架构的上游咽喉。
当所有顶级 QEC 厂商都要依靠英伟达架构来完成算法校准、甚至依赖其“NVIDIA Ising”等 AI 模型来拟合噪声时,量子处理器在物理上越脆弱,对外部 GPU 算力集群的依赖就越深。
扩展,是难题必须清醒地指出:GPU 解决的是算力效率问题,而不是微观物理问题。
把校准压缩到 2.8 秒,本质上是给系统服用了一剂立竿见影的“退烧药”,但它丝毫不能阻止超导结内部缺陷的继续劣化,也无法根除激光相位的固有抖动。
它只是让人类经典算力追上了粒子崩坏的节奏,并未从根本上延长粒子的退相干时间。
更现实的挑战在于扩展性。在包含数万个逻辑比特的大型容错机中,各模块的噪声拓扑极其异构。当成百上千个分区同时发起高频重校准,即便是顶级 GPU 网络,也将面临通信总线拥塞与惊人能耗账单的极限挤压。
但无论如何,这场 2.8 秒的闪电战击碎了物理学家的纯洁主义幻想。
通向容错量子的坦途,不是仅凭几根冷冻导线就能走通,而是一场量子芯片在微观相干边缘挣扎、宏观硅基超算在后方疯狂注水缝补的残酷混血工程。
引用:
[1]https://www.riverlane.com/blog/riverlane-and-nvidia-explores-faster-calibration-for-qec-with-nvidia-accelerated-computing
[2]https://arxiv.org/abs/2406.02700
声明:此文出于传递更多信息。若有错误或侵权,请联系