你有没有想过一个问题:为什么和 ChatGPT 聊天聊得越久,它的反应会越慢?
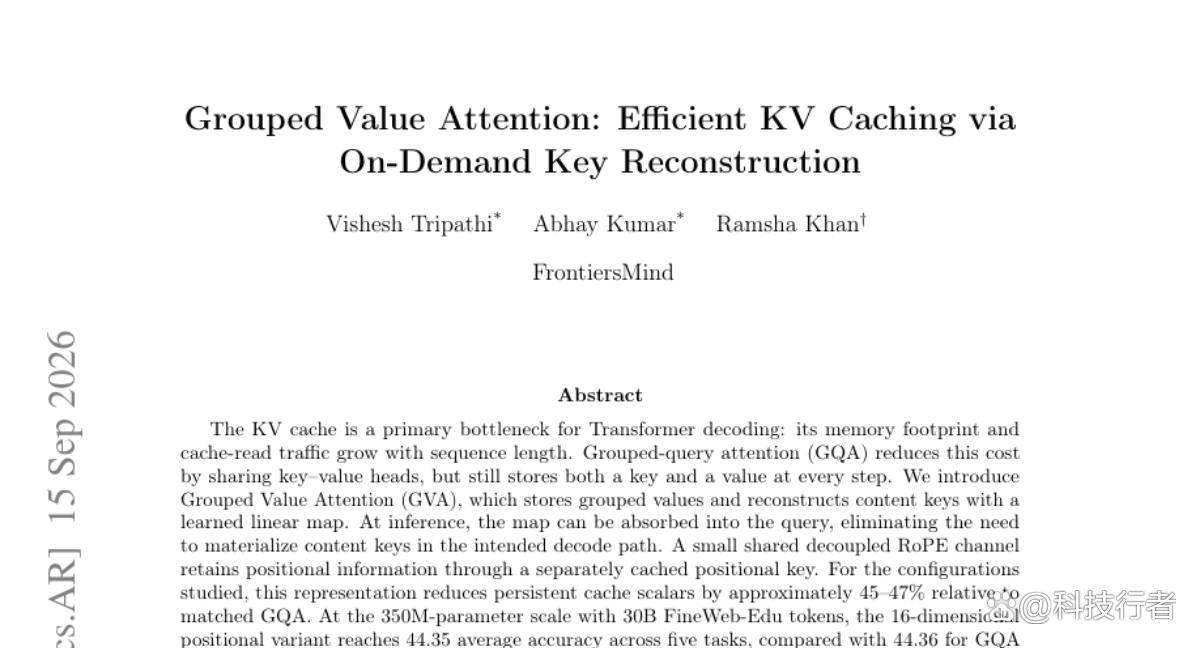
答案藏在一个叫 KV 缓存的东西里面。
KV Cache:大模型在生成文字时,需要把之前每个词的"钥匙(Key)"和"内容(Value)"都存下来,方便后面的词来查阅。这个存储区就叫 KV 缓存,随着聊天变长,它会越占越多的显存。
这就好比你在图书馆写论文,每翻过一页参考资料,你都要把这页纸复印两份贴在桌子上,一份写着"这页讲的是什么主题"(钥匙),一份是原文内容(内容)。聊得越久,参考资料翻得越多,你的桌子就被复印纸堆满了,越往后找东西越慢。如果不做任何精简,两份纸都留着,桌子迟早被占满,这就是长文本对话会越来越卡的根本原因。
这篇论文要解决的就是这个问题:能不能只贴一份纸,却依然知道该往哪儿找?
**核心问题:钥匙和内容真的需要分开存两份吗**
在 GVA 这篇论文出现之前,业界已经有几套精简方案。
最早的多头注意力,是每个"脑子"(在 Transformer 里叫注意力头)都各存一份钥匙和一份内容,谁也不共享。这样做效果最好,但显存开销也最大。
MQA:Multi-Query Attention,让所有注意力头共享同一份钥匙和内容,显存省了很多倍,但因为大家用的是同一把钥匙,模型的表达能力打了折扣,训练也容易不稳定。
后来 GQA(Grouped-Query Attention,分组查询注意力)站出来做了个折中:把很多注意力头分成几个小组,组内共享一份钥匙和内容。这个方法被 Llama 2 70B 这样的开源大模型采用,效果和速度都不错,但它依然是两份东西:一份钥匙,一份内容,一个都不能少。
再往后,DeepSeek 提出的 MLA(Multi-head Latent Attention,多头潜在注意力)更激进,把钥匙和内容压缩进一个共同的"压缩包"里存起来,缓存进一步变小,但解码过程变复杂了,需要额外的投影运算。
这几套方案有个共同的思路:钥匙和内容,天生就是两个独立的东西,必须分别存。
这篇论文的作者们提出了一个大胆的假设:真的需要两份吗?内容本身不就已经包含了"这是什么"的信息吗?
**GVA 的第一次尝试:直接把内容当钥匙用,结果崩了**
作者们最先想到的办法特别简单粗暴:既然内容里已经包含了信息,那就让钥匙等于内容,K = V,直接省掉一半的存储。
听起来很聪明,对吧?但实验结果给了当头一棒。
论文里的图 3 显示,这样做的训练损失(衡量模型学得好不好的指标,越低越好)始终比正常的 GQA 高,而且这个差距在整个训练过程里都没能补回来。
为什么会这样?
一个向量被要求同时干两件不同的活:既要负责"被别人找到"(也就是被当作内容检索出来),又要负责"帮别人判断该不该找它"(也就是当作钥匙去匹配)。这两个任务对向量的要求其实是矛盾的,硬塞进一个向量里,谁都做不好。
这就像让一个仓库管理员同时兼职当保安。管理员的职责是把货物摆放整齐方便取用,保安的职责是判断谁能进门、谁不能进门。如果你让同一个人同时干这两件事,他大概率会顾此失彼,货摆得乱,门也守不好。如果非要合并这两个岗位,仓库效率一定会下降,这正是论文中"共享 KV"实验失败的原因。
**GVA 的正式方案:内容不动,钥匙用一个小小的转换矩阵现算出来**
失败之后,作者们做了个关键的调整:不再让钥匙等于内容,而是让钥匙从内容里"推算"出来。
具体来说,论文提出的核心公式是:
Kh = Vg(h) × Mh
这句话翻译成人话就是:每个注意力头的钥匙,不是单独存出来的,而是拿对应的一组"内容"(Value),乘上一个专属于这个头的小矩阵 M,现算出来的。
M<div id="www.tlxhyy7.com6966">h:一个可学习的线性映射矩阵,作用是从存储的 Value 里"提炼"出这个注意力头专属的 Key,矩阵本身很小,不随序列长度增长。
这个设计有个很妙的地方:因为 Mh 在推理阶段是固定不变的,可以提前把它"揉进"查询向量(Query)里,而不需要真的把钥匙算出来存一份。用论文里的说法,这叫吸收,数学上等价于:先把 Query 和 Mh 做一次运算得到一个新的 Query,再拿这个新 Query 直接去和存储的 Value 做内积打分,中间那个"钥匙"从头到尾都没有被真正生成、存储过。
这就好比你去图书馆借书,不再需要图书馆提前给每本书贴一张"主题标签",而是你自己带着一份"检索规则"去查目录,规则和内容对上号就直接找到书。图书馆不用给每本书额外贴标签,省下了大量贴标签的人工和纸张,你要做的只是在查询的时候多想一步"怎么匹配"。如果不这样设计,每本书还是要贴标签,存储成本就降不下来。
这个设计带来的直接好处是:缓存里只需要存 G 组 Value(数量比头数少),却能靠数学变换,为 H 个注意力头(数量更多)各自算出不一样的钥匙。
论文管这个叫"钥匙与数值的分组不对称":GQA 是"钥匙也分组、内容也分组",而 GVA 是"内容分组,钥匙不分组,靠算出来"。
**位置信息怎么办:一个精巧的旋转补丁**
事情还没完。现代大模型普遍用一种叫 RoPE 的技术给词语标注位置信息。
RoPE:Rotary Position Embedding,旋转位置编码,通过对 Query 和 Key 向量做一种"旋转"操作,让模型知道每个词在句子里的相对位置。
问题在于,如果直接把 RoPE 应用在"现算出来的钥匙"上,前面说的那个"吸收"技巧就会失效。
原因是这样的:RoPE 的旋转角度,取决于查询位置和被查询位置之间的相对距离。这个距离对每一个缓存中的位置都不一样,没法把它提前"揉进"一个固定的 Query 变换里,因为这个变换本该对所有位置都通用,但旋转角度却随位置变化。
这就像你本来设计了一把万能钥匙,可以直接开所有房间的门,前提是所有门锁的样式必须一样。可 RoPE 相当于给每个房间的门锁都加装了一个和门牌号相关的额外旋钮,门牌号不同,旋钮转的角度也不同。这样一来,万能钥匙就不管用了,你必须针对每个门单独配一把钥匙。如果坚持用万能钥匙的思路,结果就是每次开门前都要重新配一把新钥匙,等于白白多了一道工<div id="www.xj3zb.com9750">序,速度优势荡然无存。
作者们的解决办法,借鉴了 DeepSeek MLA 的思路:把 Query 和 Key 切成两段。
一段叫"内容段",不做任何旋转,继续走前面说的"吸收"路径,从 Value 里现算出来。
另一段叫"位置段",宽度很小(论文里试了 16 维和 24 维两种),专门用来承载 RoPE 的旋转信息,而且这个位置段是所有注意力头共享的,只需要额外存一份,不用给每个头都存一份。
这样一来,既保住了"钥匙不用真正存储"的核心优势,又不丢位置信息,只是额外多付出了一点点存储代价,这个代价就是共享位置段占用的那部分空间。
**省下来的到底是多少:数字说话**
论文给出了明确的比例关系。
如果完全不考虑位置信息(理想情况),GVA 的缓存正好是 GQA 的一半,因为 GQA 要存两份(钥匙+内容),GVA 只存一份(内容)。
加上共享的位置段之后,实际节省比例会略微打折,但论文测的两个配置分别达到了大约 47%(位置段宽度为 16 维时)和 45%(位置段宽度为 24 维时)的缓存节省。
也就是说,原来要占 100 块空间的缓存,现在只需要 53 到 55 块空间就够了。
**效果掉了没有:三万亿字符的训练结果告诉你答案**
省了空间,效果会不会跟着掉?这是所有人最关心的问题。
作者在 3.5 亿参数规模的模型上,用 300 亿 token 的 FineWeb-Edu 数据集(一个专门为教育、知识类文本清洗过的高质量训练语料),分别训练了 GQA、MLA,以及好几个版本的 GVA,每个配置都用三个不同的随机种子跑了三次,取平均值,避免一次运气好坏的偶然性。
结果如下表所示,数字是五项任务(常识推理、代词消解、开放问答、简单和困难的科学推理题)的平均准确率:
| 方法 | HellaSwag | WinoGrande | OBQA | ARC-E | ARC-C | 平均分 |
|---|---|---|---|---|---|---|
| GQA | 43.41 | 52.48 | 33.40 | 63.42 | 29.09 | **44.36** |
| MLA | 43.20 | 51.61 | 34.60 | 62.87 | 27.13 | 43.88 |
| GVA 基线版 | 42.12 | 52.96 | 34.80 | 61.95 | 27.73 | 43.91 |
| GVA 尺<div id="www.xj1zbw.com4181">度匹配版 | 42.05 | **53.51** | 34.40 | 62.75 | **29.35** | **44.41** |
| GVA 位置编码16维版 | 42.69 | 53.35 | 33.60 | **63.81** | 28.32 | 44.35 |
| GVA 位置编码24维版 | 42.94 | 53.12 | 33.20 | 63.69 | 28.50 | 44.29 |
最值得关注的是最后两行,也就是论文真正推荐拿去实际部署的版本。16 维位置段的 GVA,平均分 44.35,和 GQA 的 44.36 只差 0.01 分,这个差距完全在随机种子造成的正常波动范围之内。
换句话说,用了几乎一半的缓存空间,换来的效果几乎没有任何损失。
**一个容易被忽略的坑:初始化没调对,模型会白白多走很多冤枉路**
论文里还讲了一个很实在的工程细节。
刚开始训练 GVA 的时候,那个用来"推算钥匙"的小矩阵 Mh,如果用常规的默认方式去初始化,会导致算出来的钥匙数值远远小于查询向量的数值。
这会造成什么后果?
注意力机制的核心是拿查询和钥匙做点积打分,再用 softmax 函数把分数变成一个概率分布。如果钥匙数值太小,算出来的分数几乎都一样大,softmax 出来的结果就会趋于"平均分配注意力",模型分不清该重点关注哪个词。
这就好比你拿着一把没开锁的钥匙去试每一把锁,每把锁的手感都差不多松,你根本判断不出哪把锁是真正对的那把,只能瞎猜,均匀地试。如果不修正这个初始化问题,模型要花很长时间的训练,自己慢慢把这个数值差距纠正过来,等于白白浪费了大量早期的训练资源。
论文给出了具体的修正公式,核心思路是让钥匙矩阵一开始的输出数值,和查询向量的数值大致对齐,这样从训练一开始,注意力机制就能正常工作,不用花时间"纠偏"。加上这个修正之后,GVA 版本的训练损失曲线,在很短时间内就能追上 GQA 和 MLA 的水准。
**这篇论文没做完的事**
作者们很坦诚地承认,目前的论文只测了理论上的缓存节省比例,并没有实际测出这套方案在真实服务器上跑起来到底能快多少、能多接待多少用户请求。
他们提到自己已经开发了配套的解码内核(专门优化过的底层运算代码),正在测试真实的推理速度,并计划开源,但这部分数据这篇论文里还没有给出。
也就是说,GVA 目前证明的是"存得下、学得好",还没有证明"跑得快"。这是个<div id="www.xj24zb.com9854">很关键的区分,理论上省了空间不代表实际部署时速度一定会提升,中间还隔着工程实现这一层。
Q&A
Q1:GVA 是什么,和 GQA 有什么区别?
A:GVA(Grouped Value Attention,分组值注意力)是一种新的大模型缓存方案,只存储分组后的 Value(内容),不单独存储 Key(钥匙),而是用一个学习出来的小矩阵从 Value 现算出 Key。GQA 则是钥匙和内容都要分组存储,两份都不能少。GVA 相比 GQA 能省下大约 45% 到 47% 的缓存空间,效果基本持平。
Q2:GVA 会不会因为省了缓存而导致模型效果变差?
A:根据论文在 3.5 亿参数规模、300 亿 token 数据上的实验,GVA 加上 16 维位置编码的版本平均准确率是 44.35,GQA 是 44.36,差距只有 0.01 分,在随机误差范围内,基本没有效果损失。
Q3:GVA 目前能直接拿来部署提速吗?
A:暂时还不能完全确定。论文目前只验证了理论上的缓存空间节省和模型准确率,实际推理速度和服务器吞吐量的测试还在进行中,团队已经开发了专门的解码内核,并计划开源,但相关性能数据尚未公布。
作者声明:作品含AI生成内容
举报/反馈